데이터에 4개의 이슈를 실제로 심어뒀습니다
아래 카드 중 하나를 클릭하면, 원본 데이터의 패턴 → 증거 화면 → 시스템이 내린 판단(우선순위·근거·조치)까지, 실제 로컬 실행에서 캡처한 화면으로 끝까지 따라갈 수 있습니다.
심어진 패턴
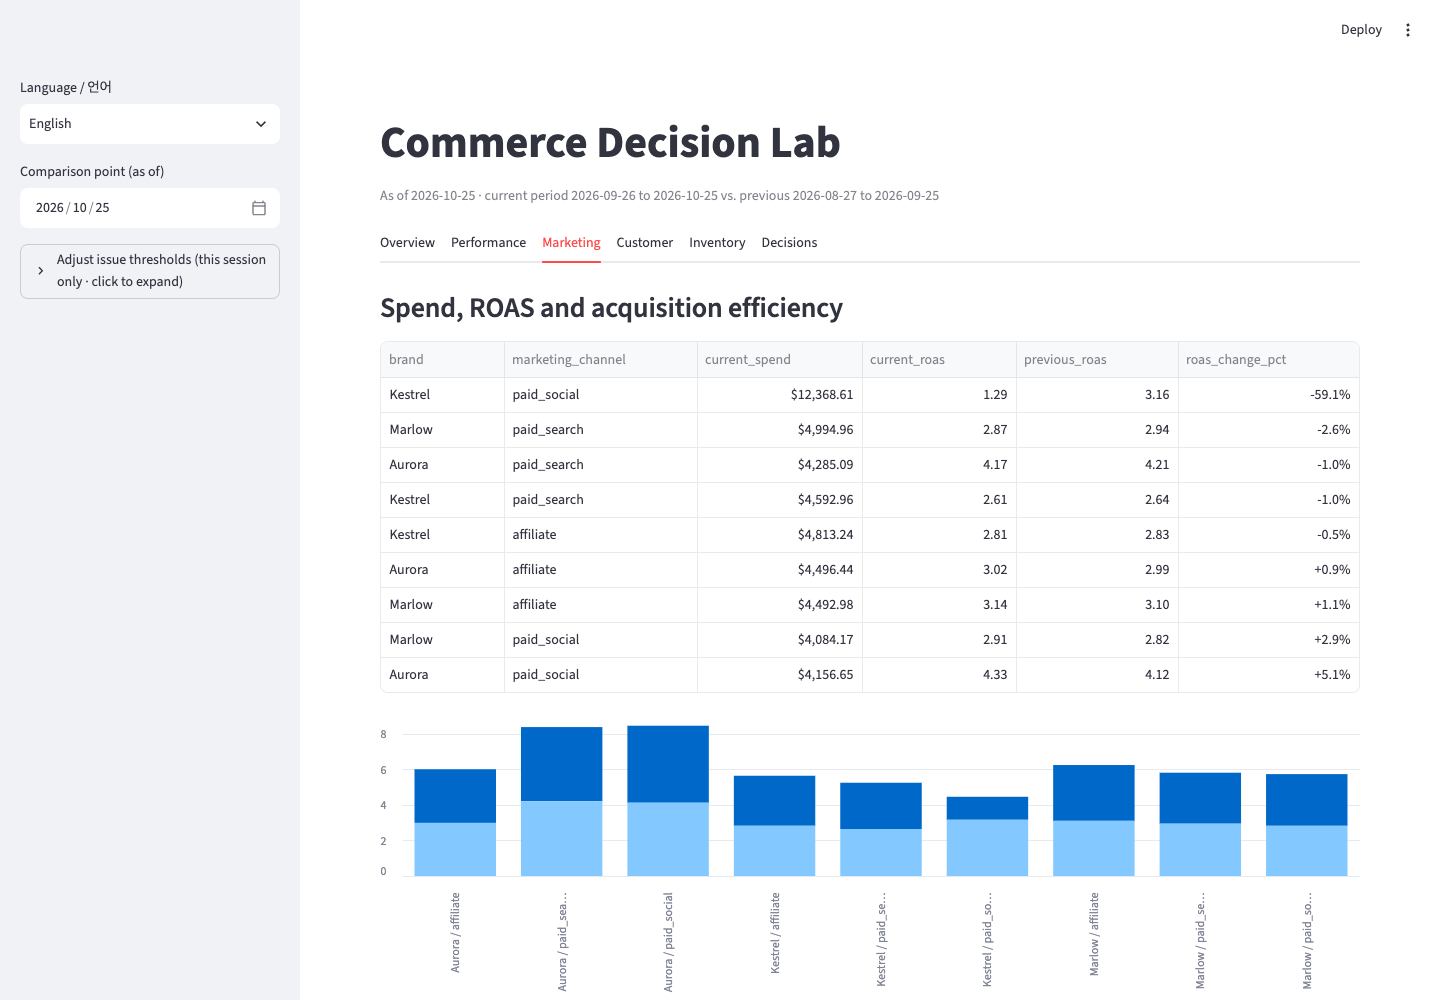
Kestrel 브랜드의 paid_social 채널에서, 최근 30일 구간 지출이 이전 구간 대비 약 2.8배로 늘었지만 기여 매출은 거의 그대로입니다. 다른 브랜드/채널 조합은 지출-매출 관계가 안정적으로 유지됩니다.
증거 — Marketing 화면
실제 KPI 테이블에서 Kestrel / paid_social 행만 ROAS가 무너진 게 보입니다.
시스템의 판단 — Decisions 카드
결정적 규칙이 roas_change_pct ≤ -40% 조건으로 high 심각도를 부여하고, 근거와 조치를 구조화합니다.
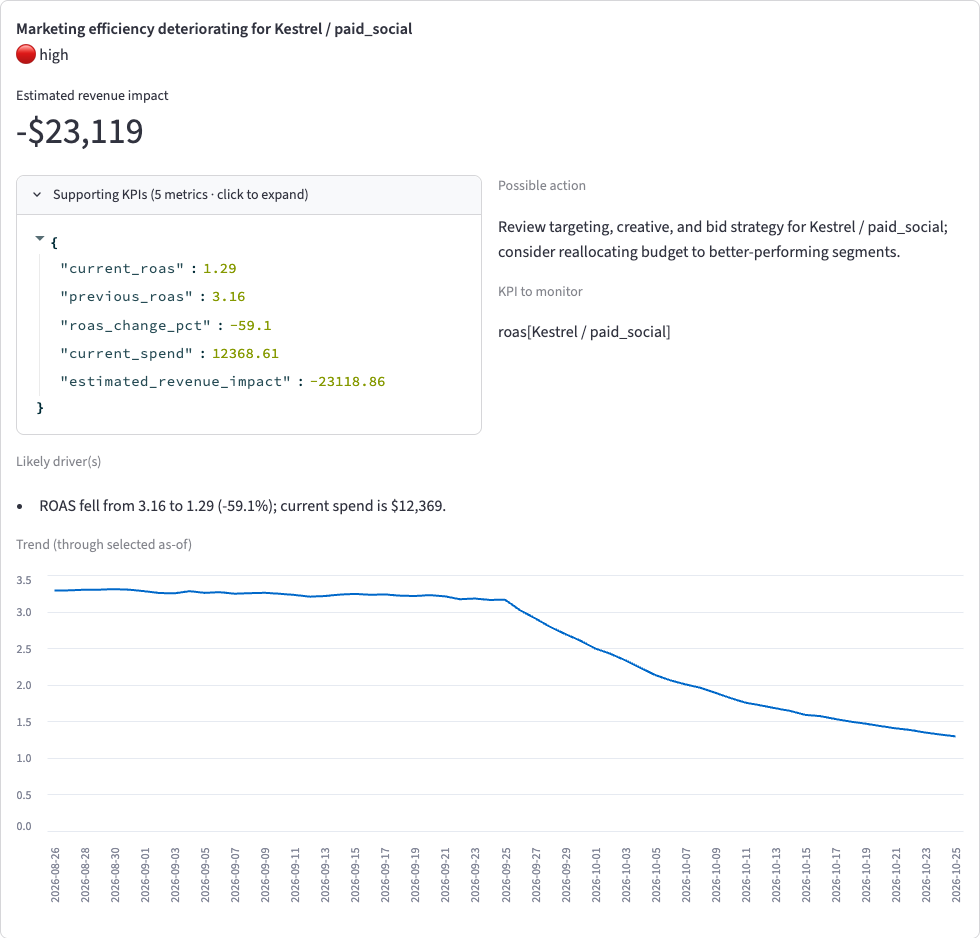
roas[Kestrel / paid_social]를 계속 지켜봄.
심어진 패턴
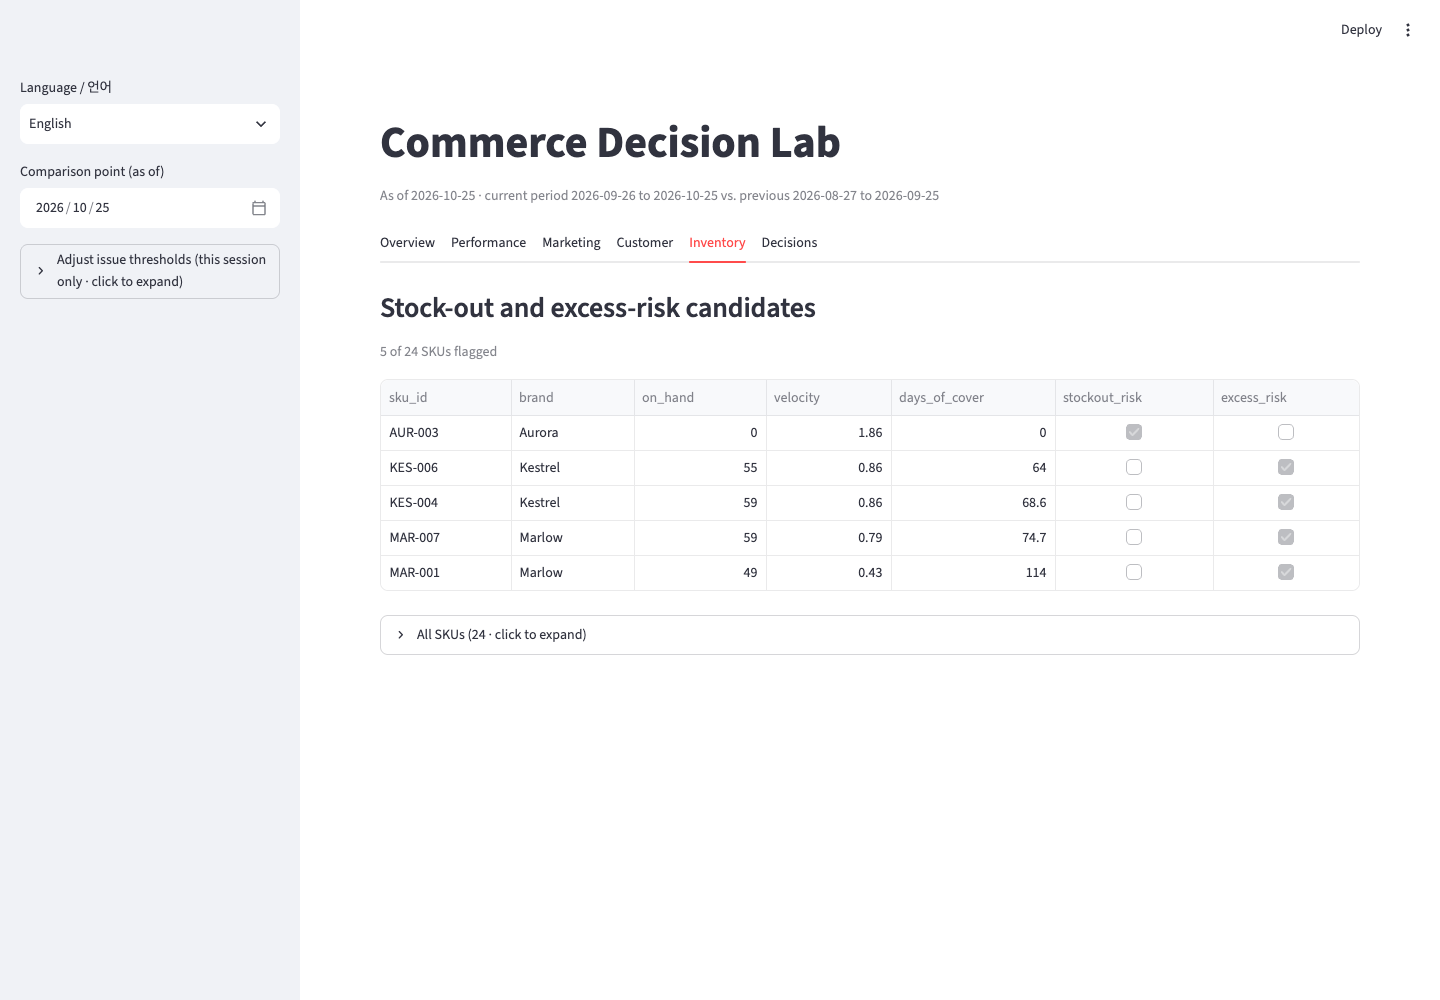
SKU AUR-003(Aurora)은 최근 구간 수요 비중이 약 2.8배로 커지는 동시에 입고가 거의 0으로 줄었습니다. 다른 SKU들은 실수요를 따라가는 반응형 재입고 정책 덕분에 20~35일 수준의 안정적인 재고 커버리지를 유지합니다.
증거 — Inventory 화면
재고 위험 후보 목록 맨 위, AUR-003만 재고 0에 재고소진일수 0.0으로 표시됩니다.
시스템의 판단 — Decisions 카드
days_of_cover < 3이면 high로 분류되는 규칙이 발동했습니다.
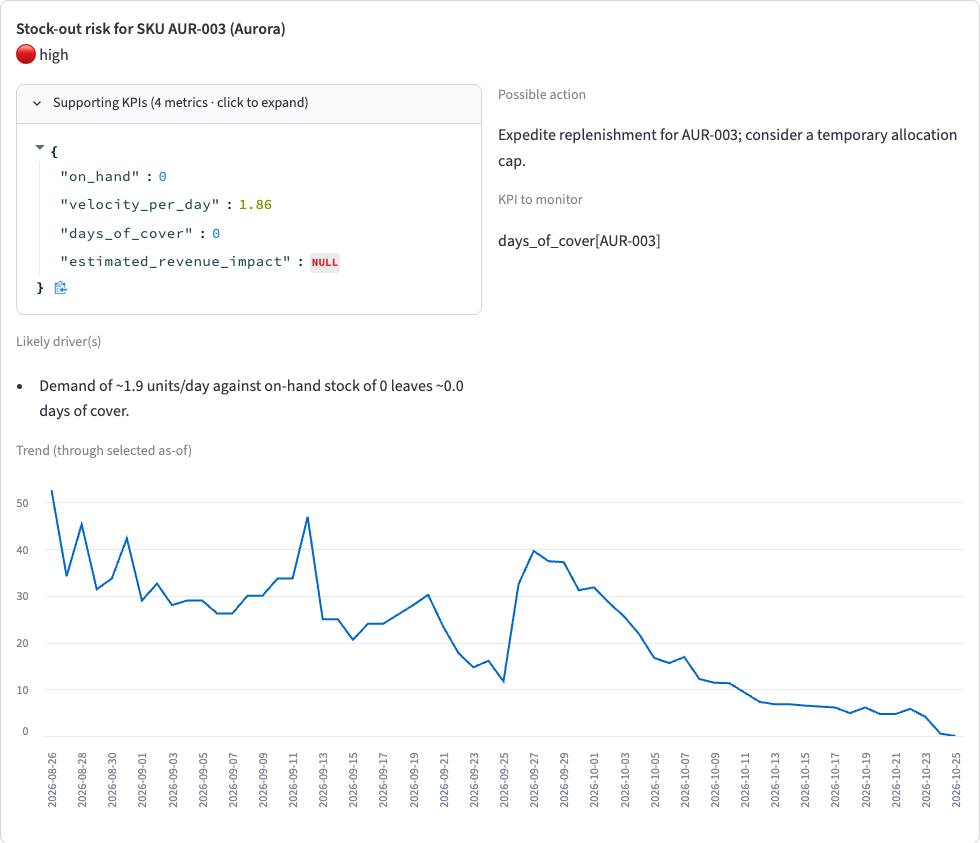
days_of_cover[AUR-003]를 계속 지켜봄.
심어진 패턴
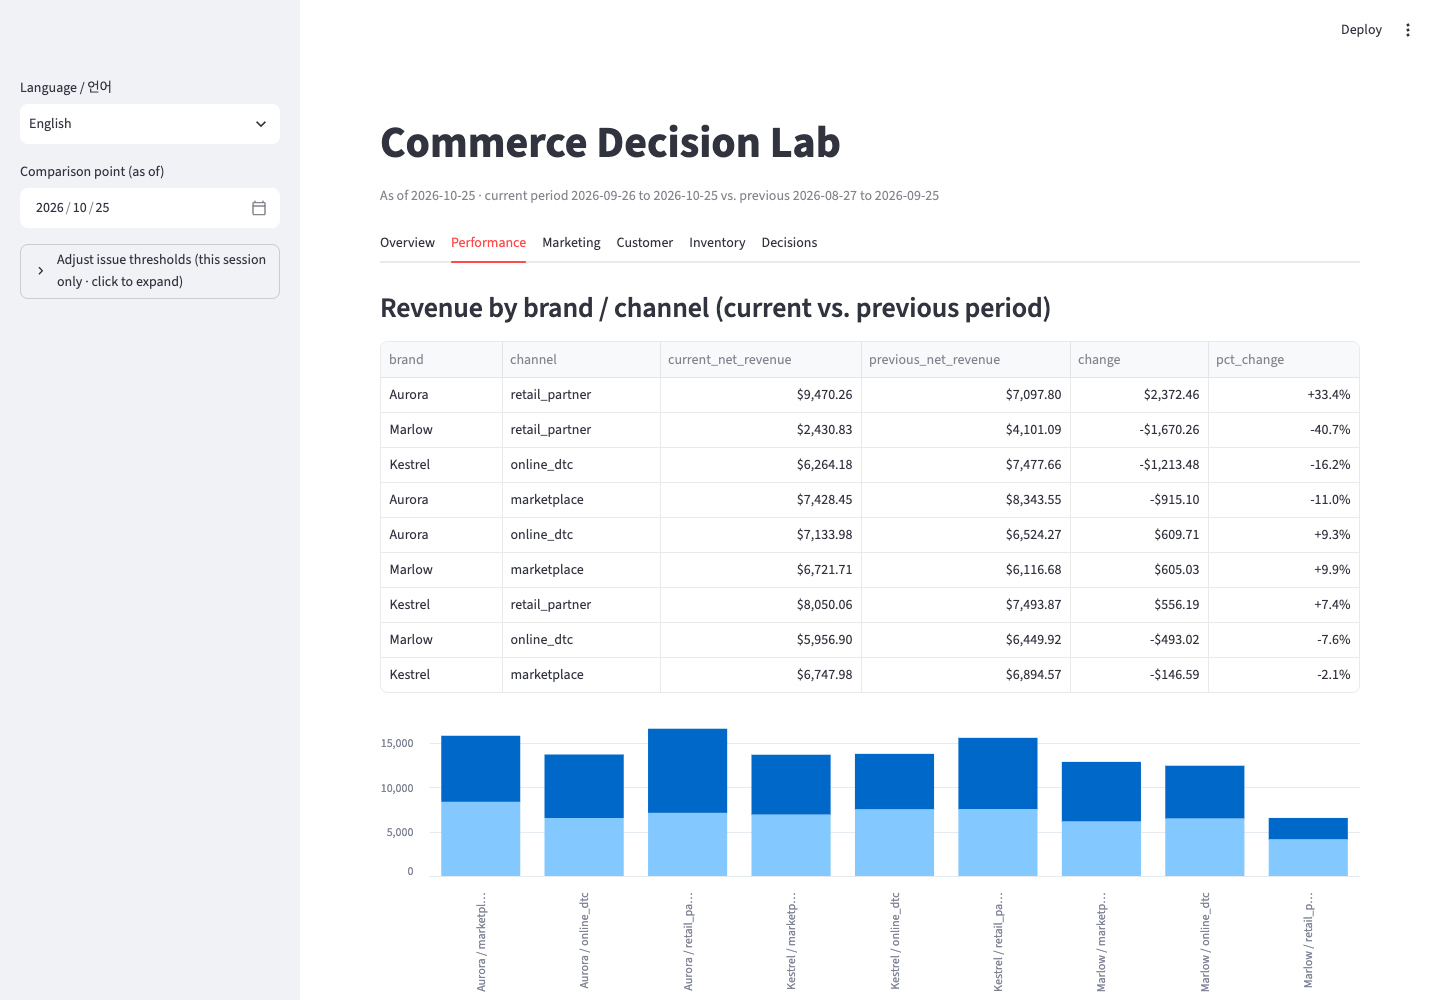
Marlow / retail_partner 세그먼트만 최근 구간 주문 비중이 줄어듭니다. 회사 전체 매출은 대체로 평탄해 보이지만, 이 한 세그먼트에서는 실질적인 순매출 하락이 발생합니다 — 전체 지표만 보면 놓치기 쉬운 패턴입니다.
증거 — Performance 화면
브랜드×채널 테이블에서 Marlow / retail_partner 행만 두드러지게 하락한 게 보입니다.
시스템의 판단 — Decisions 카드
pct_change ≤ -35% 조건으로 high 심각도가 부여됐습니다.
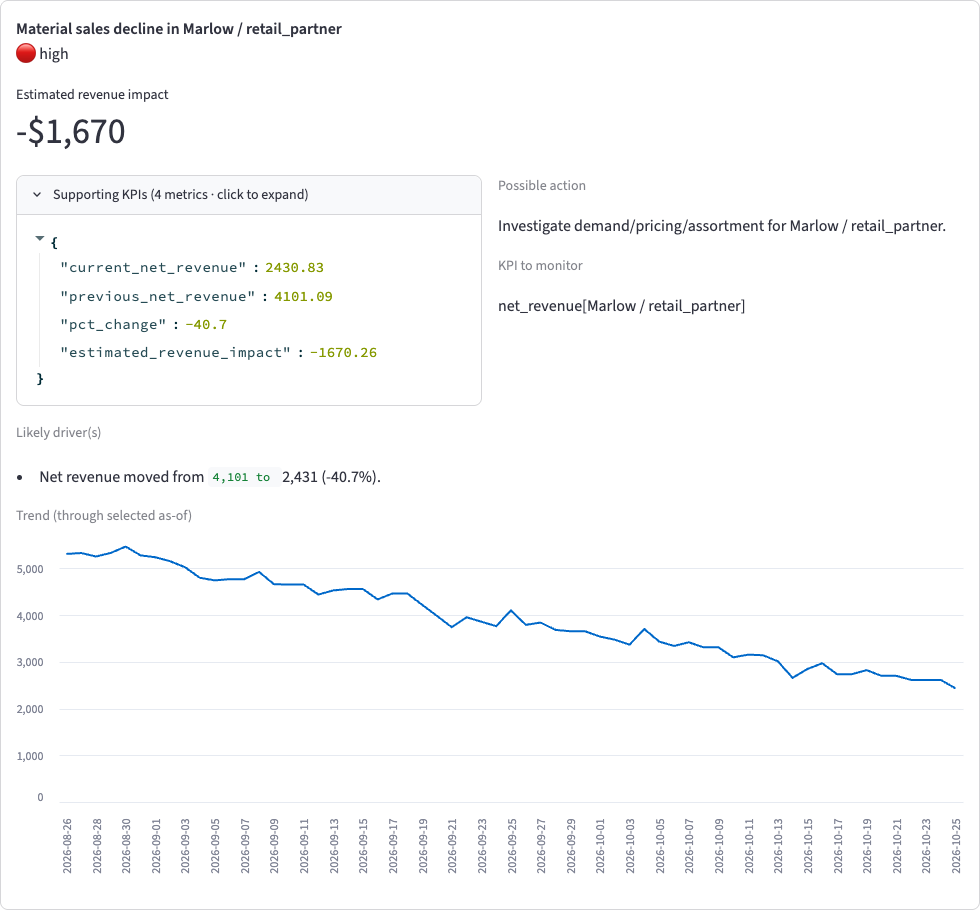
net_revenue[Marlow / retail_partner]를 계속 지켜봄.
심어진 패턴
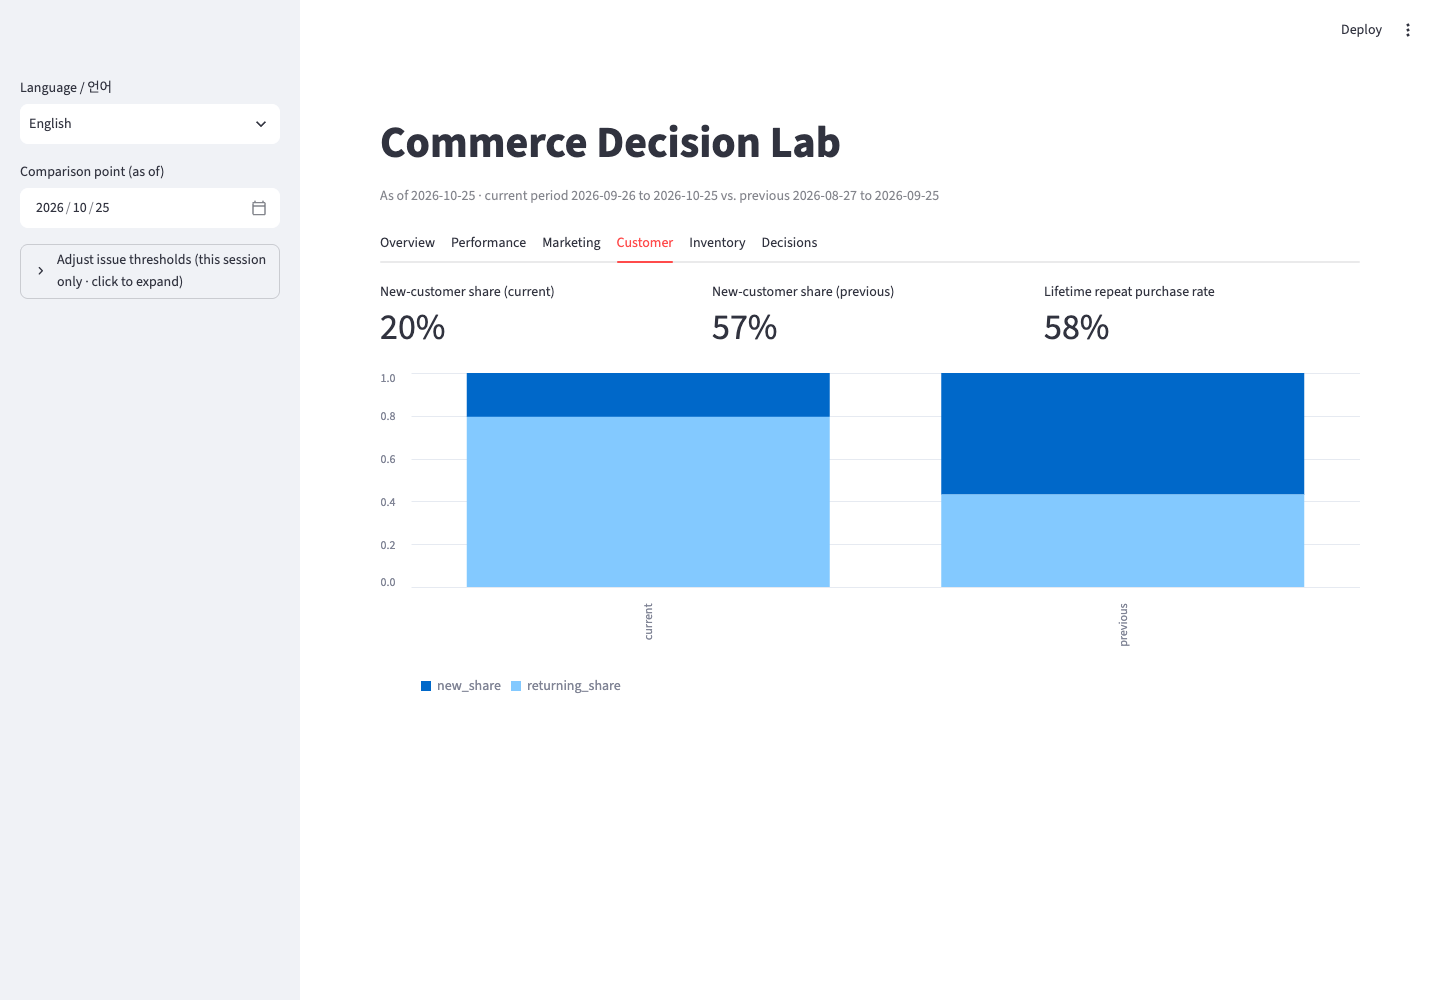
신규 고객이 주문을 낼 확률이 베이스라인 약 57%에서 최근 약 20%로 떨어졌습니다. 전체 주문 수는 크게 안 줄어들어도, 그 구성이 재구매 고객 쪽으로 크게 이동합니다 — 획득 채널이나 캠페인, 또는 트래킹 이슈를 점검해야 할 신호입니다.
증거 — Customer 화면
신규/재구매 비중 차트가 두 기간 사이에 완전히 뒤집힌 걸 보여줍니다.
시스템의 판단 — Decisions 카드
new_share_pct_change ≤ -50% 조건으로 high 심각도가 부여됐습니다.
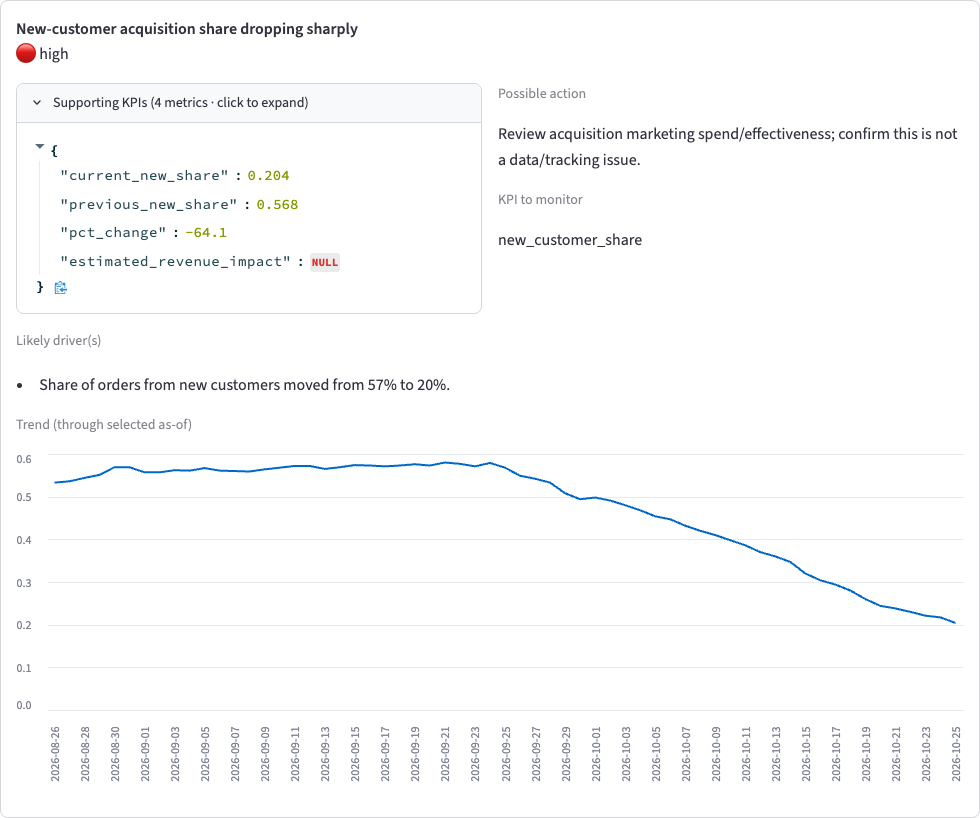
new_customer_share를 계속 지켜봄.